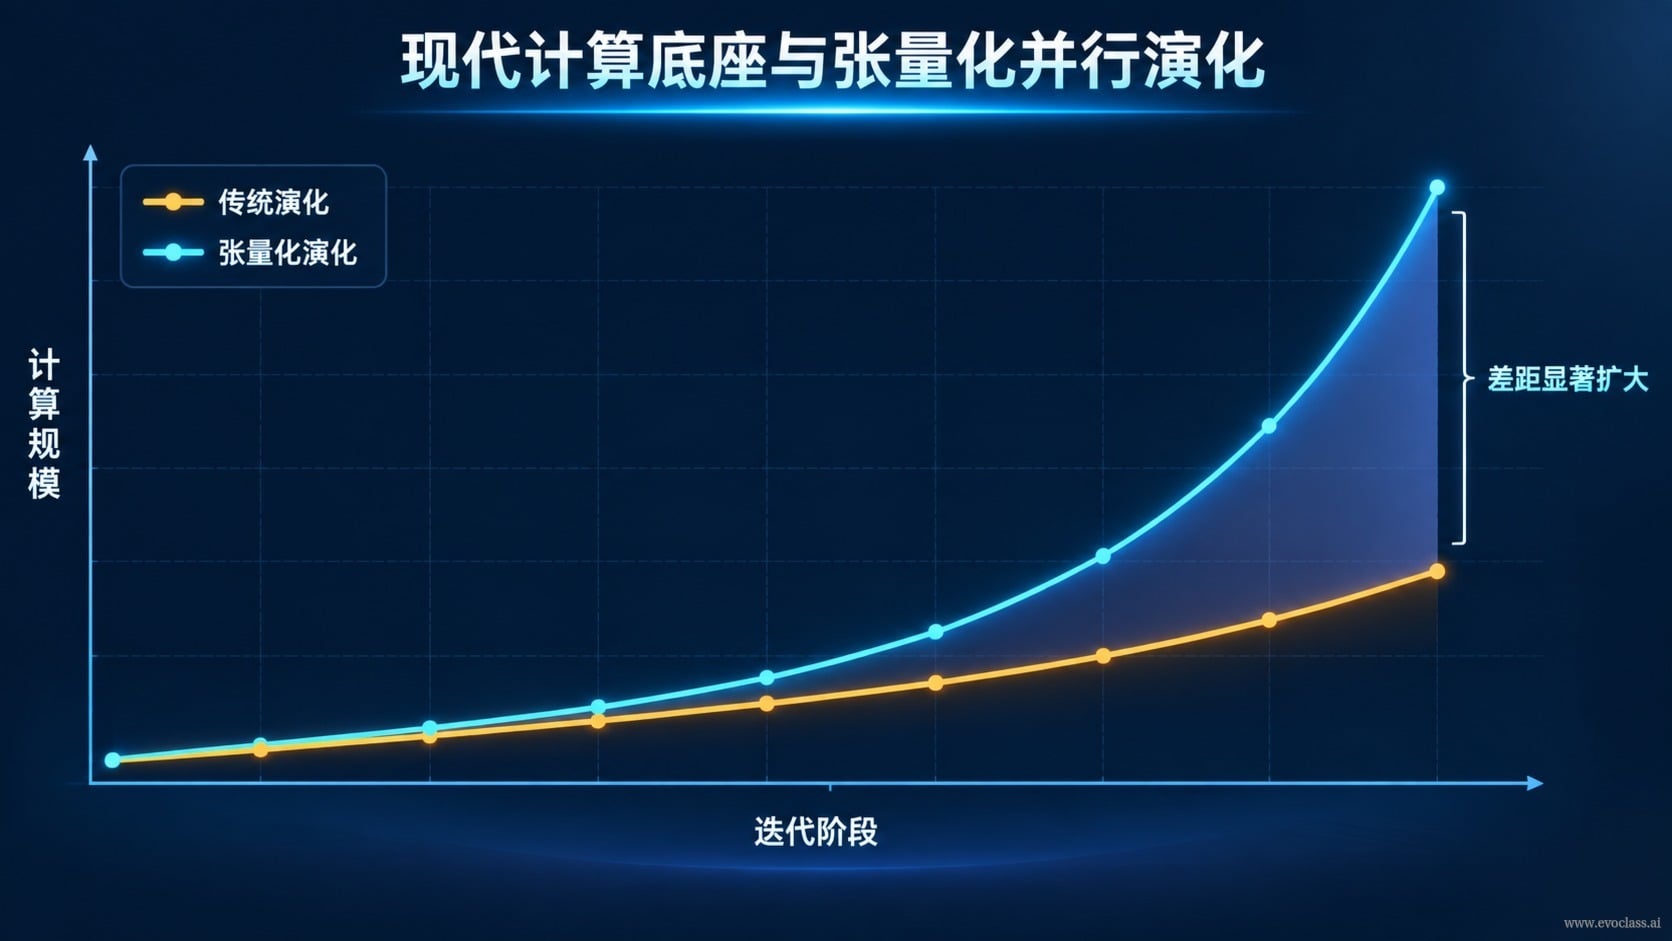
Le calcul évolutionnaire moderne est confronté à une contradiction structurelle :l'efficacité de l'évolution repose sur la diversité de la population, or cette diversité se traduit directement par un nombre d'évaluations, une gestion d'état et des coûts d'ordonnancement ; l'approche traditionnelle consistant à exécuter une boucle CPU individu par individu atteint rapidement son plafond de débit. La réponse de l'infrastructure de calcul moderne consiste à réorganiser la population, l'évaluation et l'état entenseurscalculables dans leur ensemble, en remplaçant la boucle individuelle par leparallélisme par lotssur GPU, afin de faire progresser simultanément un grand nombre de candidats au cours d'une même itération.
Pourquoi la boucle série plafonne en premier
Dans une implémentation série, chaque itération nécessite d'appeler la fonction objectif individuellement pour chaque individu, de mettre à jour son état et d'enregistrer ses journaux séparément. Lorsque la taille de la population passe de quelques dizaines à plusieurs milliers, le nombre d'évaluations croît linéairement avec cette taille, et le temps réel augmente presque aussi linéairement ; dès qu'une simulation unique (par exemple un calcul aérodynamique de haute précision) devient coûteuse, le débit global se retrouve bloqué au « rythme monocœur ». Plus la diversité est élevée et plus l'évaluation est coûteuse, plus le goulot série est marqué.
Tensorisation : organiser population, évaluation et état en tenseurs
- Tenseur de population: empiler les paramètres de tous les candidats dans un tenseur bidimensionnel (nombre d'individus × dimensions), une seule invocation d'opérateur suffisant à réaliser la mutation et la mise à jour de toute la population, au lieu d'une boucle individuelle.
- Tenseur d'évaluation: regrouper les requêtes d'évaluation par lots et les distribuer, le GPU ou un service de traitement par lots les exécutant en parallèle avant de fusionner les valeurs de retour.
- Tenseur d'état: maintenir sous forme de tenseurs les états intermédiaires tels que la fitness, les violations de contraintes et le classement, de sorte que la sélection, le tri et la mise à jour puissent être calculés de manière globale.
- parallélisme par lots: ces trois éléments réunis constituent le terme central de cette page — le parallélisme par lots. Il transforme « la charge de calcul induite par la diversité » d'un fardeau en une échelle que le débit peut absorber ; il ne s'agit donc pas d'un détail d'optimisation, mais d'une question d'infrastructure du calcul évolutionnaire moderne.
Les grands modèles repoussent la génération de candidats vers de nouvelles frontières
Une fois l'échelle de calcul ouverte, la question clé passe de « peut-on calculer ? » à « d'où viennent les candidats ? ». Les grands modèles comprennent le langage naturel, le code, les connaissances métier et le contexte du projet, et peuvent ainsi construire des candidats à la structure complexe, étendant l'objet de l'évolution d'un ensemble de paramètres numériques à des programmes, des algorithmes, voire des états système complets. Les modalités d'encodage et de mutation autrefois conçues manuellement peuvent désormais être générées en partie par le modèle. Deux forces se rencontrent alors : le GPU permet d'explorer simultanément un grand nombre de possibilités, les grands modèles font émerger des possibilités plus riches, et le mécanisme évolutionnaire envoie les candidats dans des tâches réelles, où l'exécution et l'évaluation déterminent quels changements méritent d'être conservés.
Un arbitrage architectural à l'échelle du système
Pour les ingénieurs en algorithmes et les développeurs système, ces changements n'impliquent pas une optimisation locale, mais un arbitrage architectural : il faut procéder à un compromis à l'échelle du système entre la richesse de la génération de candidats, le débit du calcul par lots et la complexité d'ingénierie. La diversité est la condition de l'efficacité de l'évolution, mais elle doit être absorbée par le débit.
Comparaison entre série et parallélisme tensoriséUn graphique linéaire compare l'échelle de calcul de l'évolution série traditionnelle et du parallélisme par lots tensorisé : avec l'évaluation individuelle sur CPU traditionnel, le nombre d'évaluations et le temps réel croissent quasi linéairement avec la taille de la population, et plafonnent dès qu'une simulation coûteuse intervient ; la tensorisation organise population, évaluation et état en tenseurs, faisant progresser un grand nombre de candidats en une même itération sur GPU, ce qui rend la diversité et l'exploration à grande échelle simultanément réalisables. Les grands modèles étendent en outre les frontières de la génération de candidats.